01
Le problème
Les représentations de V-JEPA permettent-elles de reconnaître les étapes, les erreurs et les états de composants dans des procédures industrielles réelles ? Pour le vérifier, il faut distinguer l’information visuelle des raccourcis liés au temps et tester sur des participants absents de l’entraînement.
02
Mon rôle
J’ai préparé les datasets et les protocoles d’évaluation, mis en cache les embeddings V-JEPA et comparé linear probes, MLP, ajout du temps et GRU.
03
Contraintes
- Distinguer apprentissage du contenu et exploitation de raccourcis temporels.
- Séparer les participants entre entraînement et évaluation.
- Interpréter les résultats sans confondre mémorisation et généralisation.
04
Architecture & pipeline
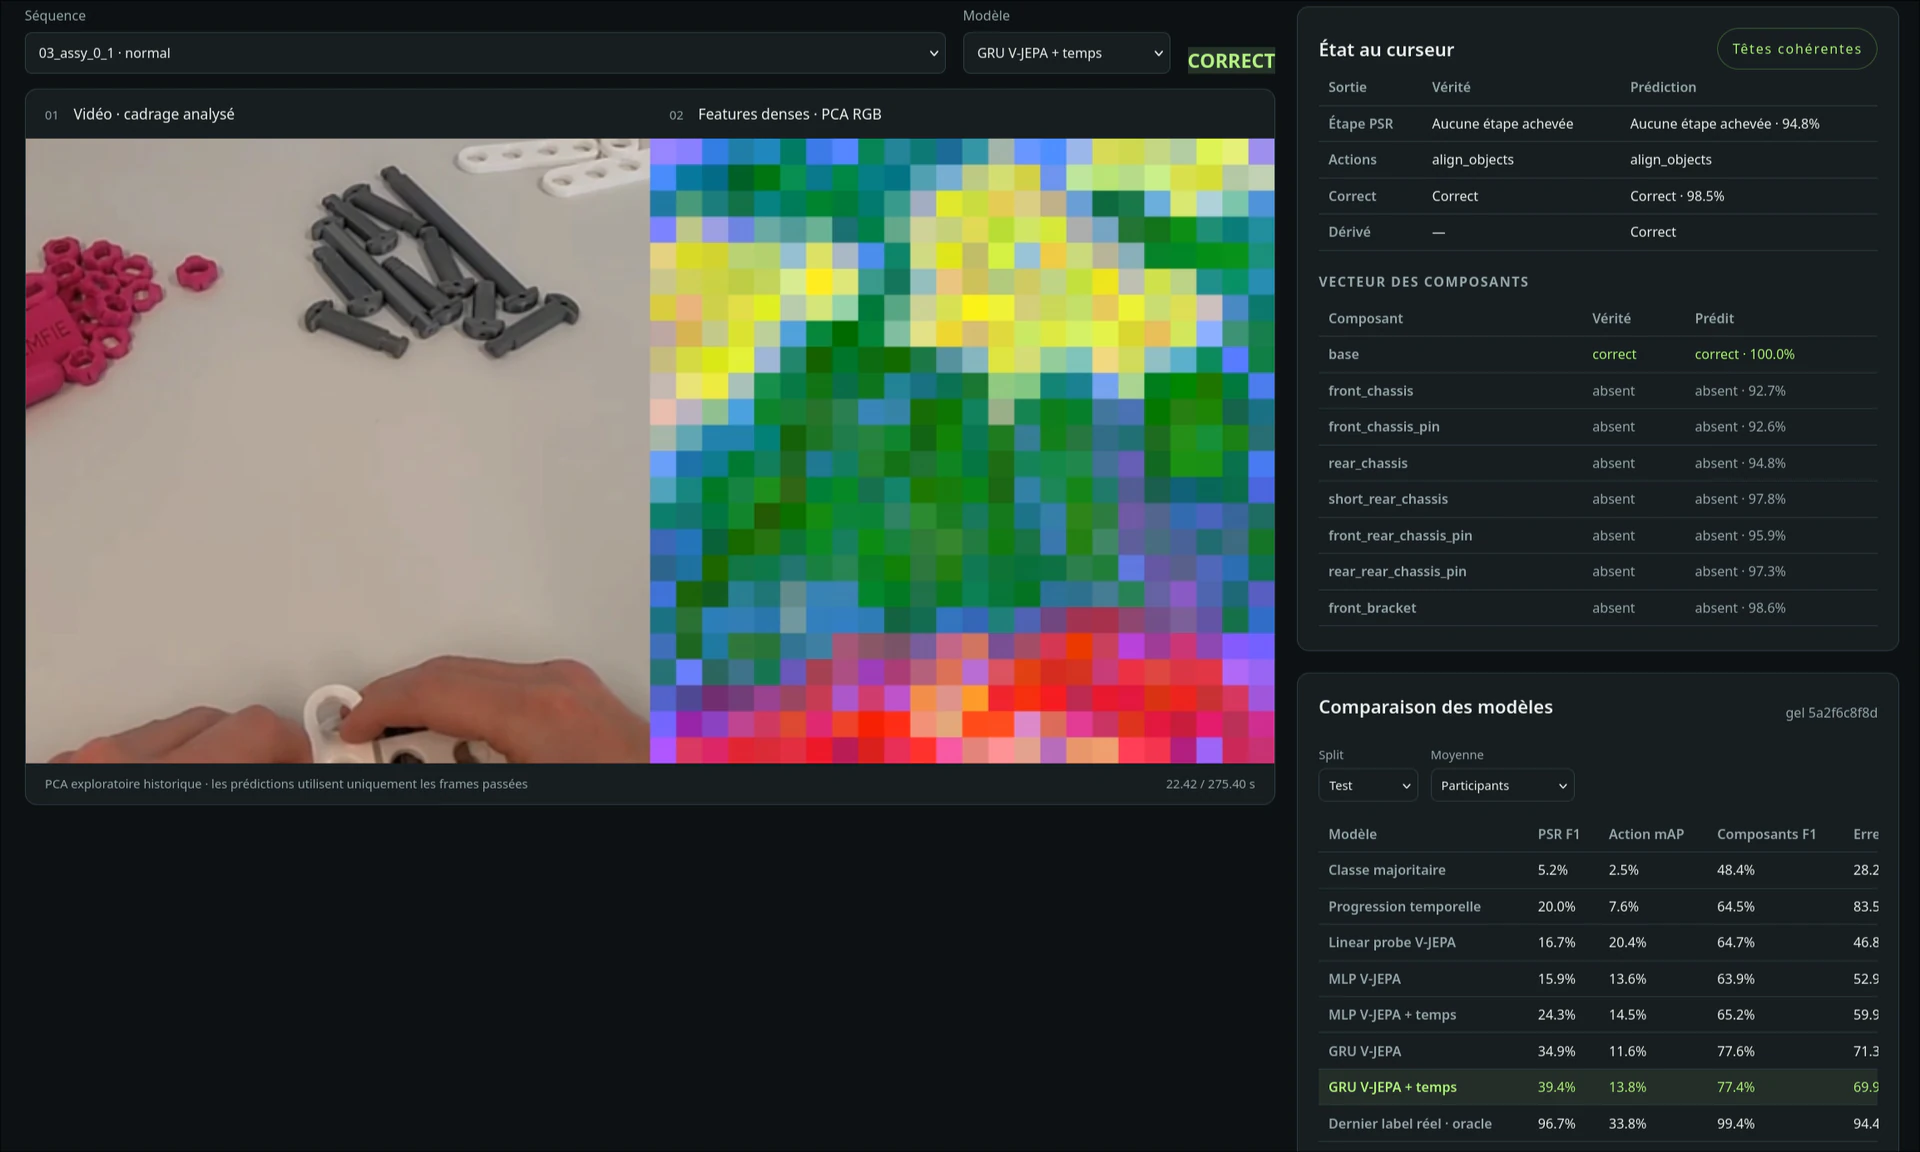
- Évaluer V-JEPA 2.1 ViT-L sur 84 séquences de procédures industrielles, avec des fenêtres d’environ 1,6 seconde.
- Comparer linear probe, MLP, ajout du temps et GRU sur les étapes, actions, erreurs et états de composants.
05
Choix & itérations
Le split par participants réduit le risque de surestimer la généralisation à partir de séquences proches.
Mettre les embeddings en cache sépare le coût d’extraction des itérations sur les modèles aval.
Une baseline temporelle teste si la position dans la procédure explique déjà une partie des cibles.
Un sanity check sur une séquence unique vérifie que le pipeline peut apprendre dans un cadre contraint ; ce test ne mesure pas la généralisation.
06
Résultats & limites
Les modèles temporels améliorent certaines tâches de séquence, notamment les étapes et les états de composants.
Sur certaines erreurs, une information temporelle simple peut concurrencer ou dépasser les embeddings. Le GRU ne résout donc pas automatiquement la détection d’anomalies.
Le sanity check atteint presque 100 % sur plusieurs cibles d’une seule séquence suffisamment entraînée. Ce résultat valide la capacité d’apprentissage du pipeline, pas sa performance en production.
07
Prochaines itérations
Comparer les représentations vidéo aux baselines temporelles sur chaque type d’erreur, avec un split par participants et un protocole stable. Identifier les gains liés au contenu visuel avant de retenir un modèle pour la détection d’anomalies.