01
Le problème
Les tableaux de garanties d’assurance santé ne suivent pas un format unique. Les assureurs changent la mise en page, les intitulés et la manière de présenter les options. Extraire du texte ne suffit pas : il faut retrouver la structure, comprendre les termes métier et permettre à un opérateur de vérifier chaque résultat.
02
Mon rôle
J’ai conçu le pipeline vision / NLP et développé l’interface de vérification Human-in-the-Loop (HITL). J’ai ensuite réécrit le cœur du MVP Python en Rust, en conservant des workers Python pour les modèles ML.
03
Contraintes
- Exécution sur le poste client, sans dépendance cloud.
- Documents et tableaux aux structures très variables.
- Résultats traçables jusqu’aux cellules du PDF original.
- Budget mémoire compatible avec les machines des utilisateurs.
04
Architecture & pipeline
- XGBoost sélectionne les pages pertinentes pour éviter les traitements d’extraction sur les pages sans garanties.
- DETR / TATR détectent les tableaux et reconstruisent leurs lignes, colonnes et cellules.
- CamemBERT classe les sous-titres et normalise les termes métier vers le schéma de garanties attendu.
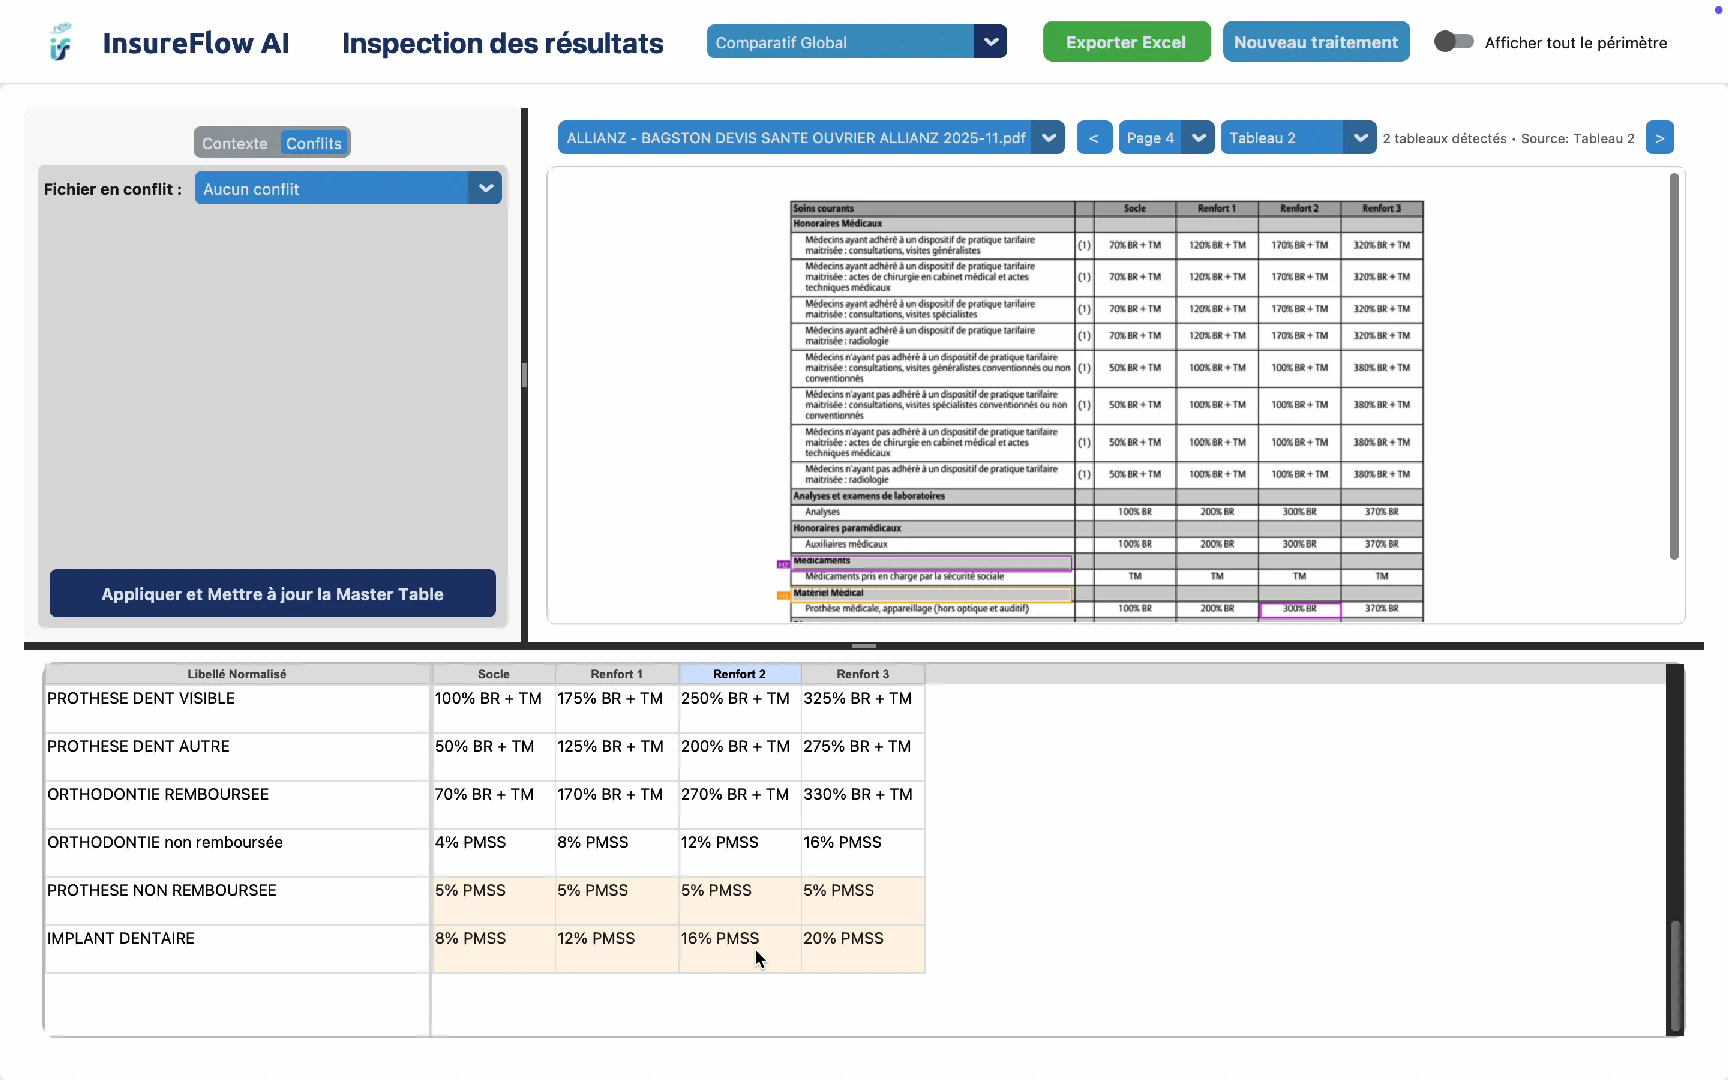
- Les bounding boxes sont reconstruites sur le PDF original : l’opérateur peut retrouver la cellule source de chaque donnée, vérifier et corriger avant l’export.
05
Choix & itérations
L’exécution entièrement locale impose de maîtriser la RAM, le chargement des modèles et leur orchestration sur le poste client, sans service distant.
J’ai séparé le cœur applicatif Rust des workers ML Python pour réduire la consommation mémoire tout en conservant les modèles et leurs bibliothèques.
J’ai relié les données extraites aux cellules du PDF original : une erreur de valeur ou d’alignement peut être vérifiée dans l’interface HITL.
Le manque de documents réels a conduit au fine-tuning de TATR sur des tableaux synthétiques. J’ai suivi séparément les lignes, les colonnes et les cellules fusionnées pour identifier les régressions.
06
Résultats & limites
La réécriture du cœur applicatif réduit la consommation RAM d’environ 70 % : de 3–10 Go à 1–3 Go selon les documents et les modèles mobilisés.
L’application extrait les garanties en local et permet de vérifier chaque donnée sur sa cellule source dans le PDF, puis de la corriger avant l’export.
Le fine-tuning sur données synthétiques améliore les lignes et colonnes, mais dégrade la gestion des cellules fusionnées. Le gain structurel ne s’étend donc pas à tous les types de cellules.
Les tableaux atypiques et les intitulés métier ambigus restent des sources d’erreur nécessitant une vérification humaine.
07
Prochaines itérations
Améliorer la génération des tableaux synthétiques, notamment les cellules fusionnées, puis réévaluer chaque élément structurel avant d’augmenter le volume de données. Comparer ensuite CamemBERT à un petit LLM sur CPU, en mesurant la qualité du mapping, la latence et la RAM.
08